X WEEKLY DIGEST · BACKEND / AGENTS

Приёмы недели из X

Восемь способов улучшить работу с AI-агентами, документацией и проверками.

21–28 сентября 2026приёмов: 8на заметку: 3постов в корпусе: 2050
О чём говорят на этой неделе

Авторы всё чаще описывают проверку работы агента как часть обычной разработки. Линтер читает документацию после правки, ревью кода начинается с точного выбора файлов, а ошибки AI-функции попадают в обновляемый набор проверок. Ещё одна заметная тема — история сессий: её сохраняют, чтобы понять, какие команды привели к результату.

01

Главные приёмы

01

Проверяй документацию после правки агента

автор:@ScarletKc
Было

Агент менял README, а устаревшие версии и повторяющиеся факты оставались в тексте.

→
Стало

Линтер seiso проверяет тип документа, ссылки и размещение фактов после записи файла.

Почему: Замечание появляется в момент правки, когда агент ещё может исправить текст. Проверки устаревших версий и повторов пока требуют --preview.

Попробовать за вечер
  • Установи seiso и выполни seiso init в небольшом репозитории.
  • Проверь предложенные типы документов в seiso.toml и включи проверку в hook после Write/Edit.
  • Измерь, сколько замечаний линтер нашёл до ревью человека.
02

Проведи аудит проверок AI-функции

автор:@HamelHusain
Было

Набор тестов агента рос без проверки того, какие ошибки он действительно ловит.

→
Стало

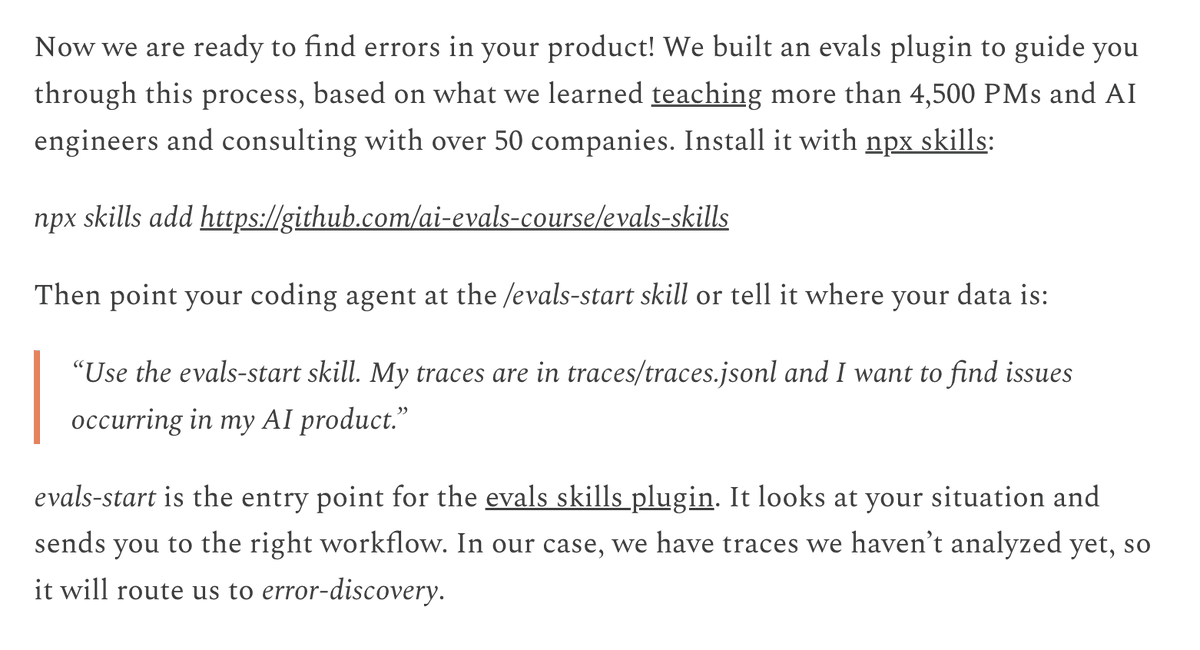
Навык eval-audit проходит по существующей схеме проверок и расставляет найденные проблемы по важности.

Почему: Так появляется список конкретных дыр в проверках. Автор не приводит измеренного выигрыша, поэтому результат стоит проверить на собственных ошибках.

Скриншот исходного материала показывает команду установки и пример запроса к eval-скиллу.Из источника↗
Скриншот исходного материала показывает команду установки и пример запроса к eval-скиллу.
Попробовать за вечер
  • Установи навыки из ai-evals-course/evals-skills.
  • Запусти /eval-audit для одной AI-функции и проверь каждое замечание по её реальным сбоям.
  • Измерь число подтверждённых замечаний и время на исправление первого.
03

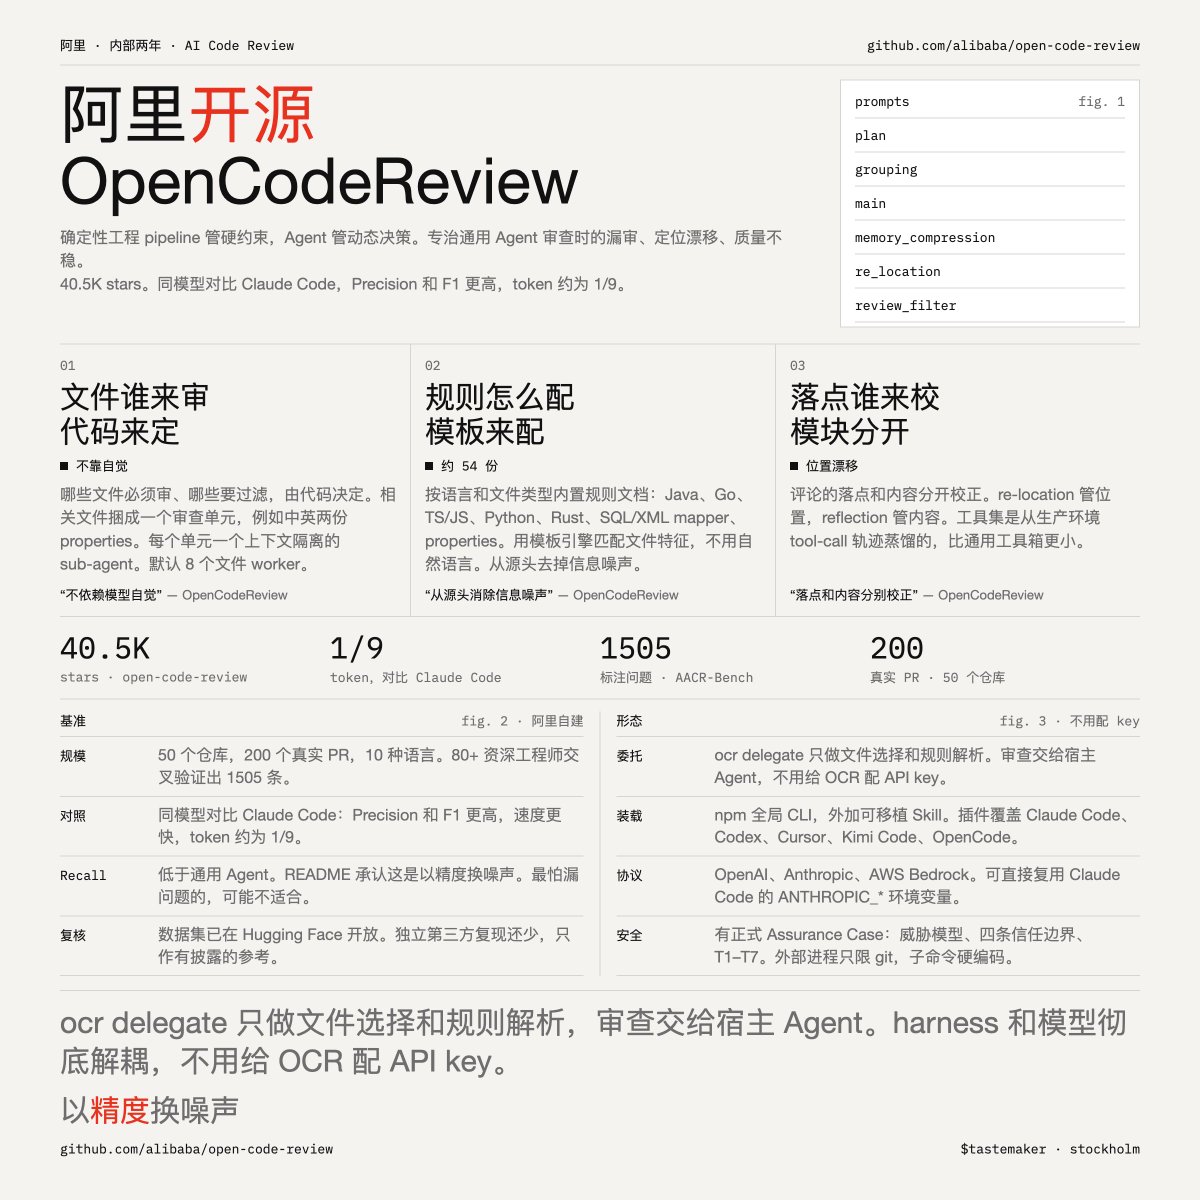
Отдели выбор файлов от AI-ревью

автор:@shao__meng
Было

Агент сам решал, какие файлы читать в большом изменении, и мог пропустить нужный diff.

→
Стало

OpenCodeReview сначала детерминированно выбирает изменённые файлы, затем поручает отдельные части агентам.

Почему: Правило выбора файлов можно проверить независимо от текста ревью. Сам проект предупреждает о компромиссе: точность выше, но полнота замечаний ниже.

Инфографика автора раскладывает проверку кода по выбору файлов, правилам и месту замечания.Из источника↗
Инфографика автора раскладывает проверку кода по выбору файлов, правилам и месту замечания.
Попробовать за вечер
  • Установи @alibaba-group/open-code-review и запусти ocr review --from main --to feature-branch на тестовой ветке.
  • Сравни список выбранных файлов и замечания с ручным ревью того же diff.
  • Измерь пропущенные дефекты и время проверки.
04

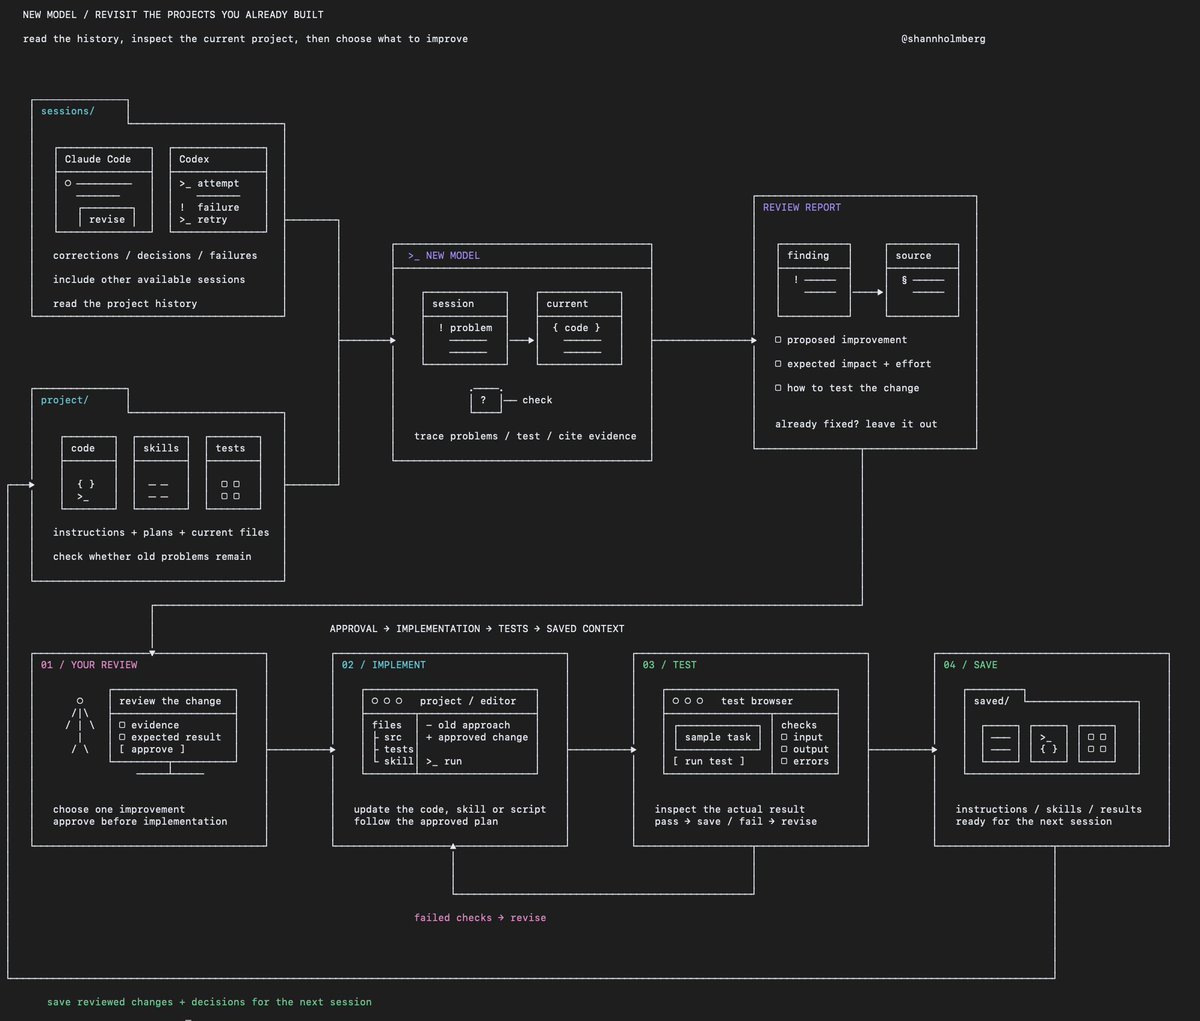
Сверь историю агента с текущим проектом

автор:@shannholmberg
Было

Повторяющиеся поправки и незавершённые задачи оставались только в старых сессиях.

→
Стало

Агент читает историю работы вместе с нынешним кодом и предлагает изменения со ссылками на конкретные сессии.

Почему: Сверка с текущим кодом отсекает проблемы, уже исправленные после той сессии. Доступность истории зависит от инструмента.

Авторская схема показывает, как новый агент анализирует историю сессий, затем предлагает проверяемое улучшение.Из источника↗
Авторская схема показывает, как новый агент анализирует историю сессий, затем предлагает проверяемое улучшение.
Попробовать за вечер
  • Попроси агента найти локальные сессии только одного проекта.
  • Пусть выпишет повторные замечания с указанием сессии и файла, затем сверит их с текущим кодом.
  • Измерь, сколько предложений подтверждено свежими проверками.
05

Собери следы работы агентов в одном месте

автор:@TiagerBao
Было

История Claude Code, Codex и Cursor лежала в разных форматах, и путь к ошибке приходилось восстанавливать вручную.

→
Стало

Agent Beacon собирает события сессий; команды beacon traces и локальная панель позволяют открыть ход работы.

Почему: Можно увидеть команды, правки и вызовы инструментов одной сессии. При настройке endpoint выбери Local явно: мастер предлагает управляемый сервис.

Попробовать за вечер
  • Установи Agent Beacon по README и при настройке выбери Local.
  • Открой beacon traces для одной завершённой сессии и проверь путь от запроса до правок.
  • Измерь, сколько времени ушло на поиск причины одной ошибки.
06

Проверяй находки аудита в песочнице

автор:@kaspirewallet
Было

Агент мог назвать подозрительный участок уязвимостью без проверки возможности эксплуатации.

→
Стало

Навык Cloudflare ведёт аудит через разведку, охват, проверку кандидатов и отдельную валидацию.

Почему: Непроверенные находки остаются гипотезами. Для полноценной проверки нужны агент с инструментами, параллельные задачи и песочница ОС.

Попробовать за вечер
  • Установи security-audit-skill в отдельном тестовом репозитории.
  • Запусти аудит на разрешённом коде и проверь, какие находки прошли валидацию, а какие остались гипотезами.
  • Измерь долю подтверждённых находок и время ручной проверки.
07

Собери проверочные запросы из сочетаний условий

автор:@HamelHusain
Было

Для проверки AI-функции придумывали несколько похожих запросов наугад.

→
Стало

Сначала перечисляют измерения запроса и вручную составляют сочетания, затем превращают их в реальные запросы к системе.

Почему: Так проще увидеть, какие случаи ещё не проверены. Синтетические запросы не показывают частоту ошибок в работе пользователей.

Попробовать за вечер
  • Назови три измерения запроса своей AI-функции и по 2–3 значения каждого.
  • Составь вручную 20 сочетаний, затем преврати их в запросы и прогони через весь продукт.
  • Измерь число новых классов ошибок; не оценивай по этой выборке их частоту в продакшене.
08

Обновляй эталонные проверки по ошибкам

автор:@HamelHusain
Было

Старый набор эталонных ответов продолжали гонять после изменения продукта и запросов пользователей.

→
Стало

Регулярный разбор ошибок добавляет новые случаи и обновляет ожидаемые ответы; бесполезные проверки отправляются на покой.

Почему: Проверки остаются связаны с текущим продуктом. После изменения набора его общий балл уже нельзя напрямую сравнивать со старым.

Попробовать за вечер
  • Возьми десять недавних сбоев AI-функции и сгруппируй их по причине.
  • Добавь новый случай или обнови ответ там, где старый тест не ловит проблему.
  • Измерь покрытие новых ошибок; для сравнения выпусков держи отдельную неизменную выборку.
02

На что обратить внимание

У этих идей пока есть ограничения, которые стоит проверить до внедрения.

Повтор команды после обрыва связи

DASP различает принятую команду и итог её выполнения. Пока это черновик: рабочих клиентов и host нет.

Пост ↗

Панель подагентов в Claude Code

Agent Flow показывает работу подагентов сбоку, но требует ранний API Claude Code; интерфейс может измениться.

Пост ↗

Передача сессии между инструментами

Пост описывает handoff из одного агента в Codex. Команду стоит сверить с документацией перед использованием.

Пост ↗
03

Мой план на неделю

До среды: проверить один README линтером seiso и разобрать замечания.
30 сентября
До пятницы: добавить в проверку AI-функции один случай из свежих ошибок.
2 октября
#

Метаданные

Собрано 2026-09-28T11:59+03:00
Окно 21–28 сентября 2026 года
Воронка 2050 постов, 85 просмотрено, 26 прочитано, 8 приёмов
Источник публичная лента Nitter через Firecrawl; метрики реакций проверены для короткого списка. Общего ранжирования по реакциям нет.
Пробелы сбора "token cost" OR "cost per token" min_faves:20; "rag pipeline" OR "retrieval" llm min_faves:30; vllm OR sglang min_faves:20; "subagent" OR "sub-agent" min_faves:20. По этим четырём темам собрано меньше пяти дней; другие цели покрыли неделю.
Медиа 3 карточки с просмотренной исходной графикой.
×
Открыть пост